Het verhaal
Het Qwen-team van Alibaba opent de gewichten van Qwen3.8-Flash-Next. In de officiële blog (gedateerd 26 augustus 2026) heet het “Today, we are sharing” en “weights are now available” op Hugging Face en ModelScope — geen countdown meer. De modelkaart is publiek, niet gated, met 131 safetensors (~360 GB). De HF-README werd om 14:29 Brussels bijgewerkt; de blog stond rond 14:52 Brussels op Hacker News.
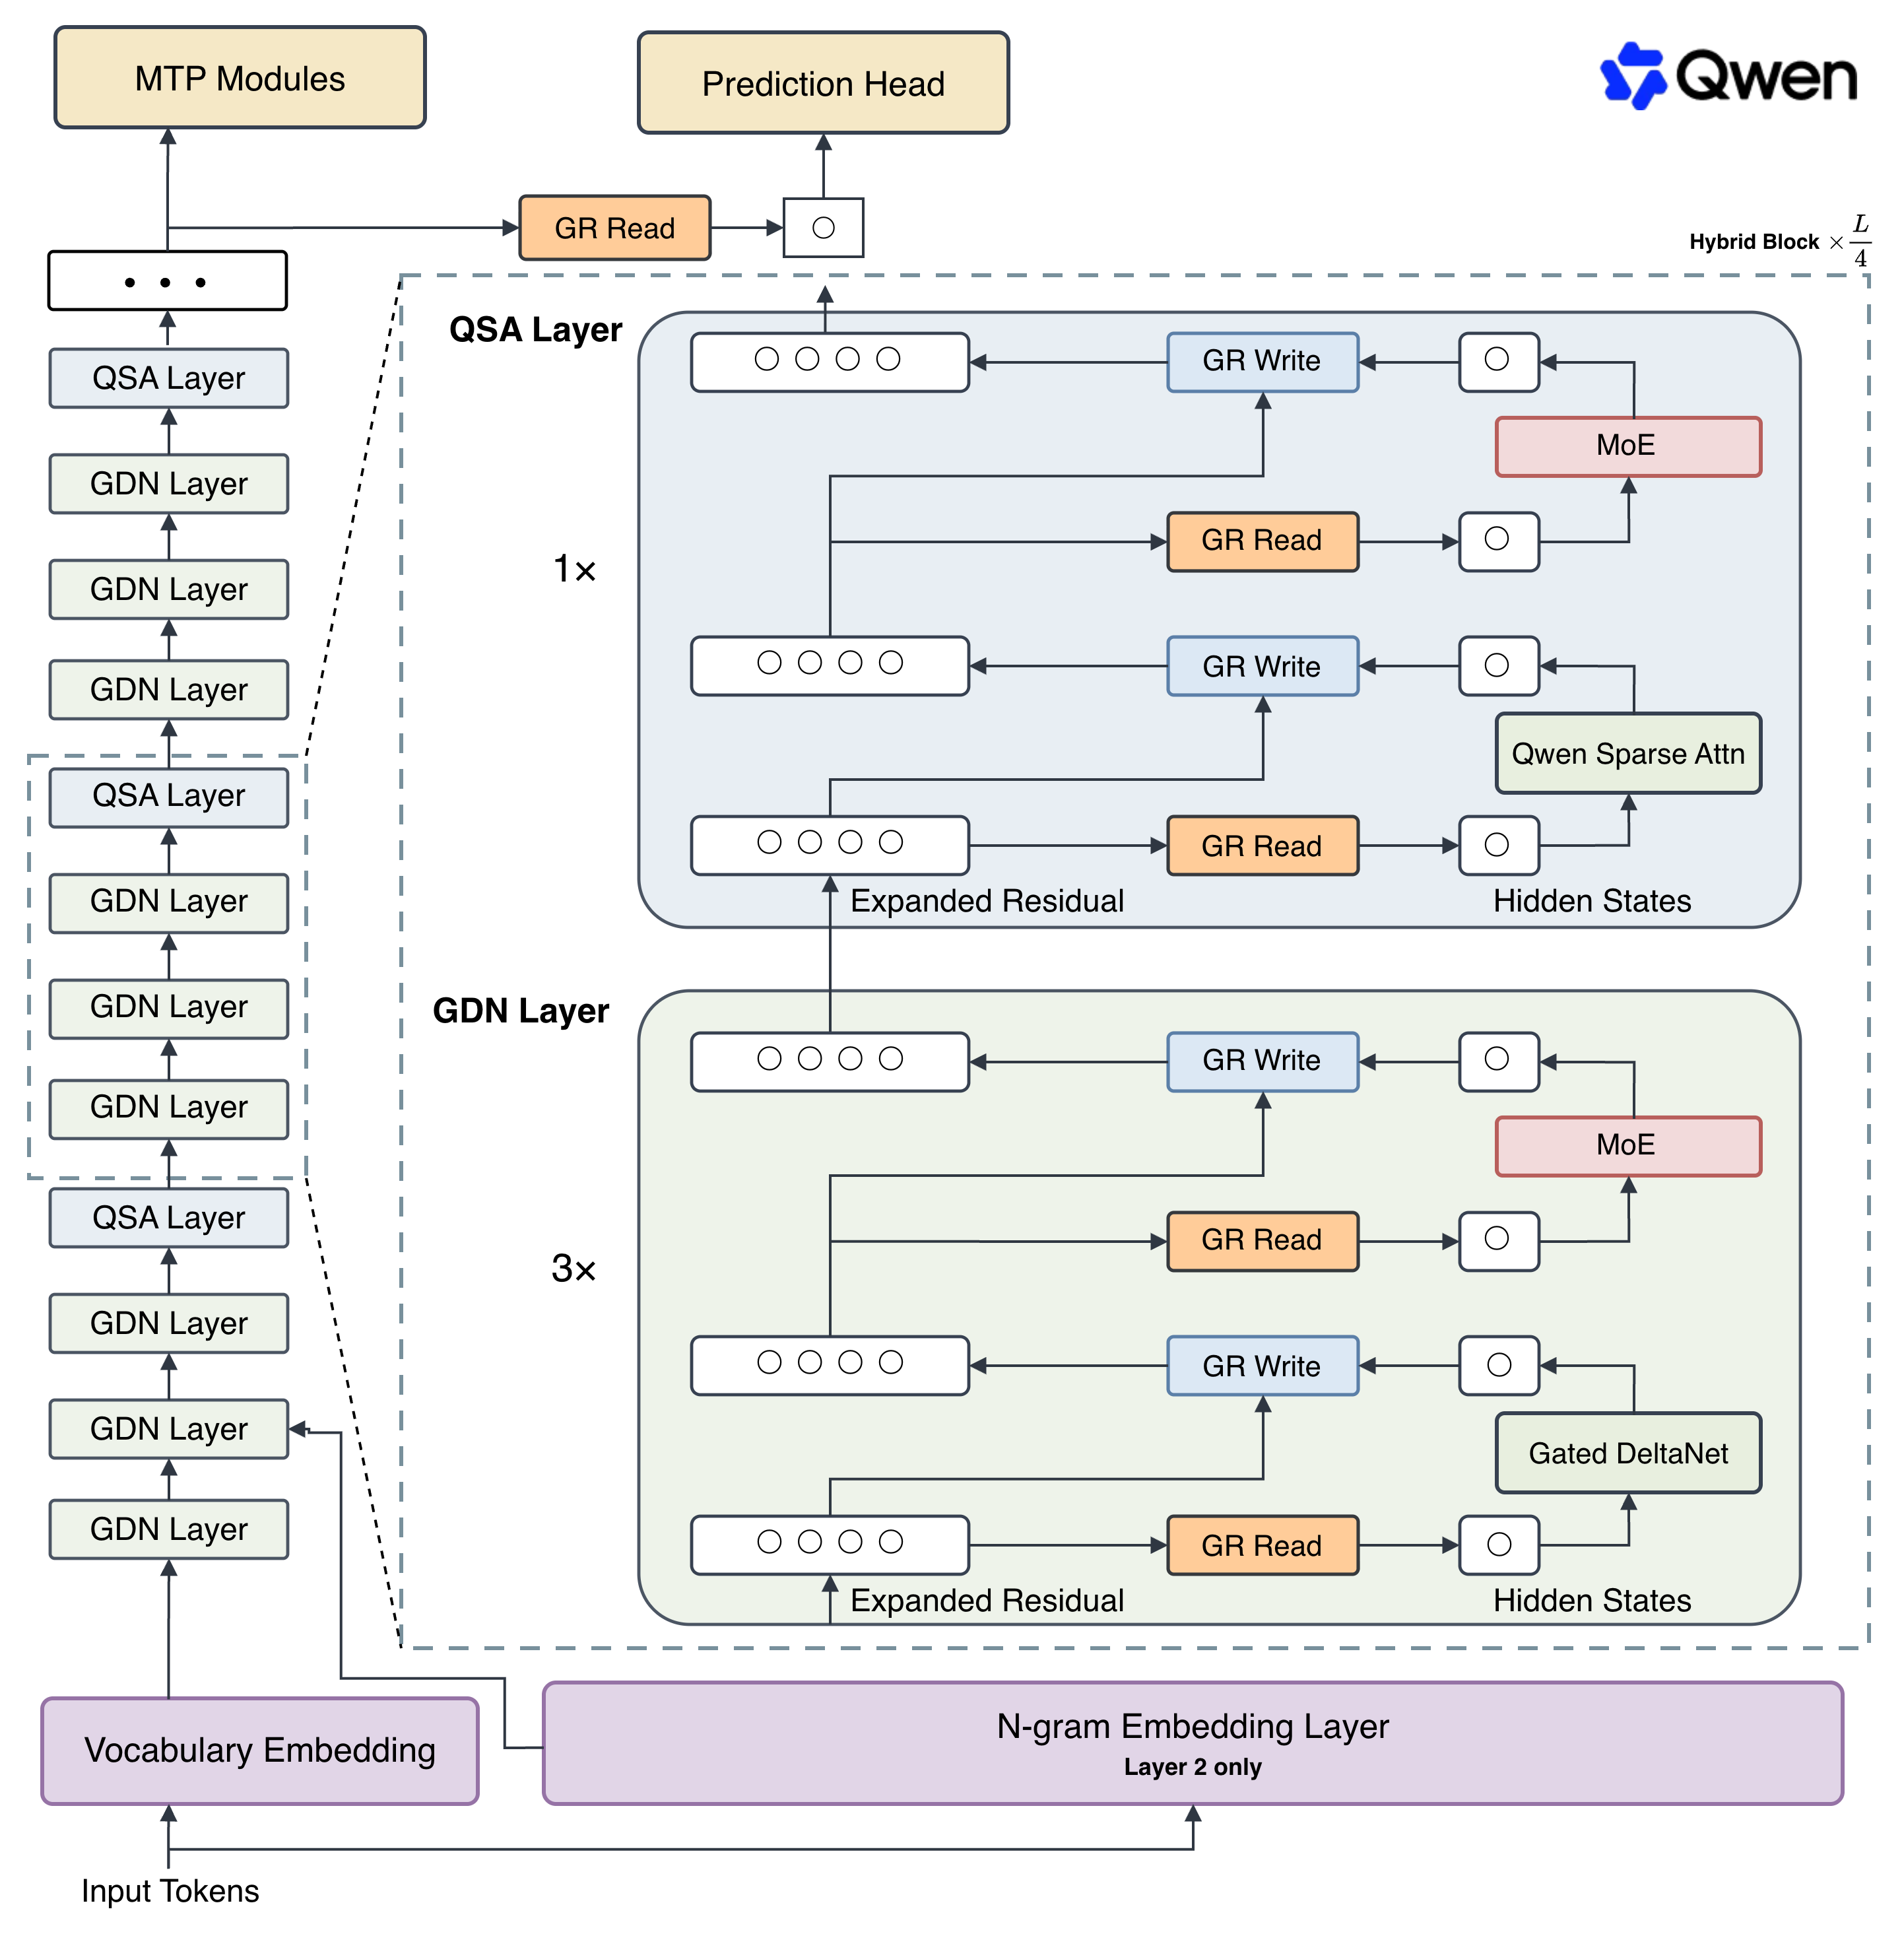
Architectuur: 125 miljard parameters waarvan 6 miljard per token actief, plus 51 miljard n-gram embeddings (offloadbaar naar host-geheugen) en 4 miljard MTP. Hybride Gated DeltaNet plus Qwen Sparse Attention, Gated Residual, Muon-optimizer. Native context 262.144 tokens, via YaRN tot 1 miljoen. Multimodaal: tekst, beeld en video. Qwen claimt dat training ongeveer een negende kost van Qwen3.7-Plus, met betere coding- en kantoorscores (o.a. 58,7 op DeepSWE 1.1 en 62,5 op SWE-bench Pro, eigen metingen).
Licentie is Qwen Community License 1.0, geen Apache 2.0. Naamsvermelding is verplicht boven 100 miljoen MAU of 20 miljoen dollar maandelijkse omzet; MaaS- en AI-work-assistant-bedrijven hebben een aparte commerciële licentie nodig. Interne inzet zonder derden blijft daarvan uitgezonderd.
De gehoste productieversie heet Qwen3.8-Flash (1 miljoen tokens standaard, officiële tools) op Qwen Cloud. In de blog stond de API bij publicatie nog op “Coming soon”. Unsloth zette dezelfde dag GGUF’s klaar.